Introducción: El arte y la ciencia de escalar en el desarrollo de software y los sistemas distribuidos
En la ingeniería de software moderna, la arquitectura de sistemas y la gestión de infraestructuras, el concepto de escalabilidad es el pilar fundamental que determina si un producto digital sobrevive al éxito o colapsa bajo su propio peso. Cuando un equipo de desarrollo se plantea la transición hacia un modelo de mayor envergadura, uno de los escenarios más críticos y desafiantes es el paso a una relación de escala específica, comúnmente conocida en entornos de optimización de recursos y replicación como el modelo de escala 1 a 3.
Este artículo experto desglosa en su primera parte los fundamentos teóricos, los análisis de impacto arquitectónico, los modelos de capacidad y las métricas clave necesarias para comprender qué significa realmente triplicar la capacidad operativa, de procesamiento o de infraestructura de un sistema sin comprometer su estabilidad, su latencia ni su rentabilidad financiera.
A lo largo de las siguientes secciones, examinaremos los cuellos de botella ocultos que suelen surgir al triplicar la carga de trabajo, los patrones de diseño recomendados por arquitectos de software avanzados, la gestión de bases de datos bajo presión de concurrencia y los marcos de trabajo para evaluar el rendimiento antes, durante y después de la transición.
1. Desmitificando la escala 1 a 3: ¿Qué significa triplicar un sistema?
Cuando se habla de pasar a una escala 1 a 3, la intuición común sugiere una solución simplista: simplemente multiplicar por tres los servidores, la memoria RAM o el presupuesto asignado. Sin embargo, en el ámbito de los sistemas distribuidos y la computación de alto rendimiento, la relación entre recursos y rendimiento rara vez es lineal.
1.1. Linealidad versus no linealidad en la infraestructura
La ley de Amdahl y las limitaciones físicas del hardware nos recuerdan que añadir más recursos no siempre se traduce en una mejora proporcional de la velocidad o la capacidad de procesamiento. Al pasar de un estado base (1) a un estado ampliado (3):
La sobrecarga de coordinación (Coordination Overhead): A medida que se añaden nodos o instancias, el tráfico de red interno destinado a la sincronización (como estados de sesiones, bloqueos distribuidos y replicación de datos) crece de forma cuadrática ( en algunos escenarios de mallado).
El factor de saturación: Un sistema que operaba al 30% de su capacidad en escala 1 puede parecer seguro, pero al triplicar el volumen de peticiones sin rediseñar los algoritmos de enrutamiento, los puntos de contención (locks) en bases de datos relacionales pueden colapsar el sistema mucho antes de alcanzar el límite teórico de las 3x unidades de cómputo.
1.2. Dimensiones de la escala
Para abordar un proyecto de esta magnitud con rigor técnico, es necesario desglosar la escala 1 a 3 en sus cuatro dimensiones principales:
Escala de Carga (Load Scale): El incremento del número de solicitudes por segundo (RPS), usuarios concurrentes activos y volumen de peticiones HTTP/gRPC entrantes.
Escala de Datos (Data Scale): El crecimiento en el volumen de almacenamiento persistente, índices de bases de datos, tamaño de cachés en memoria y flujos de eventos en tiempo real (streams).
Escala de Equipos y Procesos (Organizational Scale): Cómo impacta este crecimiento en la estructura de los equipos de ingeniería, la integración continua (CI/CD) y la gobernanza del código.
Escala Económica (Cost-to-Performance Scale): La optimización del costo por transacción (Cost per Transaction) para garantizar que triplicar la infraestructura no destruzca los márgenes operativos del negocio.
2. Diagnóstico del estado actual (Fase "1"): Auditoría y Línea Base
Antes de dar el salto hacia la escala 3, es un error crítico de ingeniería intentar escalar a ciegas. El punto de partida (la unidad "1") debe ser perfectamente comprendido, medido y documentado.
2.1. Métricas de Observabilidad Imprescindibles
Para establecer una línea base sólida, el equipo de arquitectura debe recopilar datos cuantitativos precisos utilizando herramientas de observabilidad modernas (como Prometheus, Grafana, Datadog o OpenTelemetry). Las métricas clave que deben auditarse incluyen:
Latencia en percentiles altos (P95 y P99): No basta con medir el tiempo de respuesta promedio; los picos de latencia son los primeros en degradarse cuando la carga comienza a incrementarse.
Tasa de errores (Error Rate): Identificar el porcentaje exacto de códigos de estado HTTP 5xx, timeouts y fallos de conexión bajo la carga actual.
Utilización de recursos por componente: Uso de CPU, memoria RAM, E/S de disco (IOPS) y saturación de ancho de banda de red en cada microservicio o componente monolítico.
Concurrencia de bases de datos: Número de conexiones activas, consultas lentas (slow queries) y tiempo de espera en el pool de conexiones.
2.2. Identificación de los Cuellos de Botella Actuales (Bottleneck Mapping)
Todo sistema tiene un eslabón más débil. Al intentar triplicar la escala, ese eslabón se romperá primero. Mediante pruebas de estrés y análisis de perfiles (profiling), se deben identificar los siguientes elementos restrictivos:
CPU-bound vs. I/O-bound: Determinar si los procesos consumen principalmente ciclos de procesador (requiriendo algoritmos más eficientes o paralelización) o si dependen de operaciones de entrada/salida (requiriendo mejores estrategias de caché o bases de datos asíncronas).
Bloqueos de base de datos: Identificar tablas con alto contention donde múltiples transacciones compiten por actualizar la misma fila o registro simultáneamente.
3. Estrategias de Arquitectura para el Crecimiento: Patrones de Diseño
Una vez diagnosticada la línea base, el diseño de la arquitectura debe evolucionar para soportar con solvencia el factor de multiplicación 3x. Dependiendo de si la aplicación es un monolito maduro o un ecosistema de microservicios, se deben aplicar patrones específicos.
3.1. Escalado Horizontal versus Vertical
Escalado Vertical (Scale Up): Consiste en aumentar la potencia del servidor existente (más CPU, mayor RAM). Aunque es el enfoque más sencillo a corto plazo, tiene un límite físico insostenible y un punto de fallo único (Single Point of Failure - SPOF).
Escalado Horizontal (Scale Out): Es la piedra angular para alcanzar la escala 1 a 3 de manera robusta. Implica distribuir la carga entre múltiples instancias idénticas utilizando equilibradores de carga (Load Balancers) con algoritmos avanzados como Least Connections o Round Robin ponderado.
3.2. Desacoplamiento mediante Colas de Mensajes y Brokers de Eventos
Cuando se triplica el volumen de transacciones, la comunicación síncrona directa (como llamadas REST encadenadas) provoca efectos en cascada donde un fallo en un servicio menor tumba toda la aplicación. La introducción o refuerzo de un sistema de mensajería asíncrona (como Apache Kafka, RabbitMQ o AWS SQS) permite:
Absorber picos de tráfico repentinos (Traffic Buffering).
Garantizar la entrega de eventos críticos mediante reintentos controlados y políticas de Dead Letter Queues (DLQ).
Desacoplar a los productores de datos de los consumidores, permitiendo que cada capa escale a su propio ritmo.
4. Gestión de Bases de Datos y Persistencia ante el Factor 3x
El almacenamiento de datos suele ser el talón de Aquiles en cualquier estrategia de escalabilidad. Mientras que los servidores de aplicaciones se replican fácilmente añadiendo contenedores en Kubernetes o instancias en la nube, las bases de datos enfrentan desafíos complejos de consistencia y concurrencia.
4.1. Estrategias de Lectura y Escritura (Read Replicas)
Para un escenario donde el tráfico y las consultas se multiplican por tres, la arquitectura de base de datos debe separar las operaciones de lectura de las de escritura:
Base de datos primaria (Master): Dedicada exclusivamente a gestionar las operaciones de escritura (INSERT, UPDATE, DELETE) y transacciones críticas.
Réplicas de lectura (Read Replicas): Conjunto de nodos secundarios (idealmente 2 o más para cumplir con la proporción de escala) sincronizados de manera asíncrona o semi-síncrona con la primaria, encargados de absorber el 80% o más del tráfico de consultas (SELECT).
4.2. Optimización de Caché en Memoria (Caching Layers)
Implementar o escalar una capa de caché distribuida (como Redis o Memcached) es obligatorio al pasar a una escala 1 a 3. Las estrategias recomendadas incluyen:
Cache-Aside Pattern: La aplicación verifica primero la caché antes de consultar la base de datos persistente.
Invalidación basada en eventos: Asegurar que los datos en caché se actualicen o expiren correctamente cuando ocurren modificaciones en el backend, evitando inconsistencias de lectura (stale reads).
5. Próximos pasos en la transición
En esta primera parte hemos establecido el diagnóstico inicial, la comprensión de los límites del sistema y los patrones arquitectónicos y de persistencia esenciales para preparar el terreno. Sin embargo, la teoría debe traducirse en un plan de ejecución operativo.
(En la segunda parte de este artículo profundizaremos en la ejecución de las pruebas de estrés bajo escenarios de alta concurrencia, la automatización del despliegue mediante infraestructura como código (IaC), los planes de mitigación de fallos y las métricas financieras para evaluar el Retorno de Inversión — ROI — de este crecimiento estructural).
¿Te gustaría que profundicemos en algún aspecto específico de esta primera fase, como la configuración de las réplicas de lectura o el diseño de las capas de caché, antes de avanzar con los siguientes puntos?
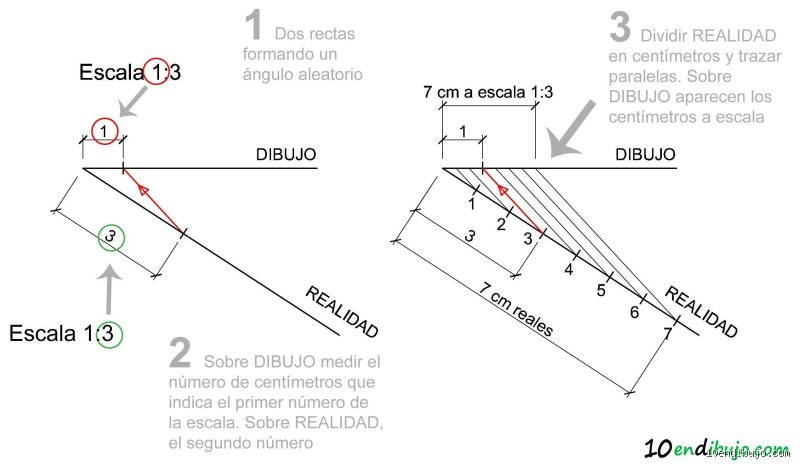
<div class="article-continuation"> <h2>Optimización y consolidación de la transición geométrica</h2> <p>Continuando con el análisis técnico sobre la modificación de proporciones métricas, resulta fundamental entender que la manipulación de factores dimensionales no tolera la improvisación. Nosotros debemos verificar minuciosamente cada trazo antes de validar el resultado definitivo en el plano de trabajo. A fin de lograr una transición exitosa hacia esta proporción específica, es necesario aplicar fórmulas matemáticas precisas que eviten cualquier margen de error estructural. <strong>La precisión milimétrica marca la diferencia entre un proyecto profesional y un simple boceto amateur.</strong> Resulta casi gracioso ver cómo algunos todavía confían en el azar para calcular proporciones complejas, esperando que el papel se dibuje solo por obra de magia.</p> <p>Para ejecutar este cambio de manera eficiente, el proceso técnico exige seguir una serie de pautas operativas fundamentales:</p> <ul> <li>Calcular el factor de proporción inicial dividiendo la medida real entre el valor representado en el formato original.</li> <li>Multiplicar las dimensiones base por el coeficiente correspondiente para adaptarlas al nuevo esquema métrico.</li> <li>Comprobar los puntos de referencia utilizando un escalímetro certificado o herramientas digitales de verificación geométrica.</li> <li>Ajustar los grosores de línea si la reducción o ampliación altera la legibilidad visual del conjunto gráfico.</li> </ul> <p>Analicemos ahora el comportamiento de las áreas y los volúmenes bajo esta normativa espacial. Mientras que las longitudes se modifican de forma lineal, las superficies experimentan variaciones exponenciales que demandan nuestra máxima atención técnica. Si ignoras este principio físico, los cálculos de materiales o espacios sufrirán desviaciones críticas que arruinarán el propósito inicial del diseño. Tu responsabilidad como operador técnico consiste en anticipar estas alteraciones volumétricas antes de imprimir o fabricar el prototipo final.</p> <h2>Errores frecuentes y recomendaciones finales</h2> <p>Durante la ejecución práctica, los profesionales suelen tropezar con obstáculos recurrentes que ralentizan el flujo de trabajo. Un error típico radica en confundir las unidades de medida al pasar los datos del sistema real al formato reducido (lo cual genera discrepancias catastróficas en el montaje). Debemos mantener la coherencia métrica desde el primer cálculo hasta el sellado final del documento técnico.</p> <p>En conclusión, dominar esta transformación métrica consolida tu destreza técnica y garantiza estándares de calidad impecables en cualquier disciplina de diseño o ingeniería. La práctica constante transformará un procedimiento aparentemente complejo en una tarea fluida y completamente natural dentro de tu rutina profesional.</p> </div>