❤️ Familia y relaciones Hijos y crianza
¿Puedo extraer texto de una imagen?
Una guía experta para dominar la tecnología OCR y el procesamiento inteligente de documentos
Respuesta corta
La respuesta corta y directa a la pregunta es un rotundo sí: hoy en día no solo es posible extraer texto de una imagen, sino que este proceso se ha vuelto increíblemente rápido, preciso y accesible gracias a la evolución de la tecnología de Reconocimiento Óptico de Caracteres (OCR, por sus siglas en inglés) y, más recientemente, a la inteligencia artificial multimodal.
En pocas palabras
- Cuando envías una imagen a un software de extracción de texto, se desencadena una cadena de procesamiento de alta complejidad matemática.
- No todas las imágenes son iguales ante los ojos de un motor de OCR.
- Para llevar la teoría a la práctica de manera efectiva, es fundamental conocer cuáles son las herramientas más potentes y accesibles disponibles en la actualidad.
- Incluso con los algoritmos de Inteligencia Artificial más avanzados, la calidad del resultado final depende en gran medida de la calidad de la imagen de origen.
- La versatilidad del OCR ha transformado la manera en que interactuamos con la información visual en múltiples sectores:
En este artículo
- Fundamentos tecnológicos: ¿Qué es el OCR y por qué revolucionó el manejo de datos?
- Anatomía de un motor de OCR: ¿Qué sucede bajo el capó?
- Factores críticos que determinan el éxito de la extracción
- Herramientas líderes en el mercado para la extracción de texto (OCR)
- Cómo maximizar la precisión: Consejos para una extracción perfecta
- Casos de uso prácticos en el entorno moderno
- Limitaciones actuales y el futuro del OCR
- En resumen
La respuesta corta y directa a la pregunta es un rotundo sí: hoy en día no solo es posible extraer texto de una imagen, sino que este proceso se ha vuelto increíblemente rápido, preciso y accesible gracias a la evolución de la tecnología de Reconocimiento Óptico de Caracteres (OCR, por sus siglas en inglés) y, más recientemente, a la inteligencia artificial multimodal.
Fundamentos tecnológicos: ¿Qué es el OCR y por qué revolucionó el manejo de datos?
El Reconocimiento Óptico de Caracteres (OCR por sus siglas en inglés, Optical Character Recognition) es una tecnología que permite la conversión de diferentes tipos de documentos —tales como documentos de papel escaneados, archivos PDF o imágenes capturadas con cámaras digitales— en datoseditable y buscables procesados por computadoras.
Para entender la magnitud de esta tecnología, debemos pensar en cómo una computadora percibe una imagen común (como un archivo JPEG o PNG). Para un sistema informático, una imagen no es más que una gigantesca matriz numérica de píxeles, donde cada celda contiene valores de color y brillo (RGB o escala de grises). Carece por completo de la noción semántica de "una letra A", "una palabra" o "un párrafo".
El puente entre esa matriz estática de píxeles y el texto plano editable es lo que el OCR logra construir mediante algoritmos matemáticos, procesamiento de señales y, en las versiones más modernas, redes neuronales profundas.
La evolución histórica: De las plantillas mecánicas a los transformadores visuales
La historia del OCR no nació con las computadoras modernas; sus raíces se remontan a principios del siglo XX con dispositivos de asistencia para personas con discapacidad visual, como el "Optífono" de Fournier d'Albe (1914) o el aparato de Emanuel Goldberg en la década de 1920 que utilizaba fotocélulas para reconocer caracteres impresos.
Primera generación (Coincidencia de patrones o Template Matching): Durante las décadas de 1960 y 1970, los sistemas comparaban la imagen de un carácter píxel por píxel con una base de datos de fuentes predefinidas. Si la coincidencia era alta, se validaba el carácter. Este método era extremadamente rígido: cualquier cambio mínimo en la fuente, el tamaño, la inclinación o un ligero desgaste del papel provocaba errores catastróficos.
Segunda generación (Extracción de características o Feature Extraction): En las décadas de 1980 y 1990, los sistemas evolucionaron para buscar atributos geométricos y topológicos específicos de los caracteres (líneas rectas, curvas, bucles, intersecciones, ángulos). Esto hizo que el reconocimiento fuera más tolerante a variaciones tipográficas.
Tercera generación (Redes Neuronales y Aprendizaje Profundo): A partir de la década de 2010, la irrupción de las Redes Neuronales Convolucionales (CNN) y las Redes Neuronales Recurrentes (RNN), combinadas con arquitecturas de atención como los Transformers, transformaron por completo el panorama. Hoy en día, los sistemas no solo miran letras aisladas, sino que comprenden el contexto lingüístico completo de la oración para corregir errores al vuelo.
Anatomía de un motor de OCR: ¿Qué sucede bajo el capó?
Cuando envías una imagen a un software de extracción de texto, se desencadena una cadena de procesamiento de alta complejidad matemática. Aunque el proceso ocurre en milisegundos, pasa por varias etapas críticas:
[ Imagen Original ]
│
▼
[ Preprocesamiento ] (Binarización, corrección de inclinación, reducción de ruido)
│
▼
[ Segmentación ] (Detección de líneas, palabras y caracteres individuales)
│
▼
[ Reconocimiento ] (Extracción de características y modelos de IA / Redes Neuronales)
│
▼
[ Postprocesamiento ] (Corrección ortográfica, diccionarios contextuales y formato final)
A. Preprocesamiento de la imagen
Una imagen del mundo real rara vez está en condiciones óptimas. Puede estar borrosa, mal iluminada, inclinada o tener un fondo texturizado. El preprocesamiento limpia el terreno:
Binarización: Convierte una imagen a escala de grises o color en una imagen estrictamente en blanco y negro (umbralización de Otsu, por ejemplo), separando nítidamente el texto del fondo.
Corrección de inclinación (Deskewing): Si el documento fue fotografiado de lado o torcido, los algoritmos rotan la matriz geométrica para alinear las líneas de texto horizontalmente.
Reducción de ruido: Elimina manchas, puntos de polvo, grano digital o sombras irregulares que podrían confundir al algoritmo haciéndole creer que son partes de un carácter.
B. Segmentación estructural
Una vez limpia la imagen, el motor realiza una descomposición jerárquica:
Detección de bloques: Identifica dónde están los párrafos, las columnas, las imágenes y las tablas.
Segmentación de líneas: Separa el bloque de texto en líneas individuales.
Aislamiento de caracteres o palabras: Divide las líneas en unidades léxicas que serán analizadas por el clasificador.
C. Reconocimiento e inferencia
Aquí es donde entra el núcleo de la inteligencia artificial. Los modelos modernos basados en arquitecturas como CRNN (Convolutional Recurrent Neural Network) analizan las características visuales secuenciales de las palabras y estiman la probabilidad estadística de que una secuencia de formas corresponda a una determinada palabra en un idioma específico.
D. Postprocesamiento contextual
Incluso si el motor reconoce con un 98% de precisión los glifos visuales, pueden surgir ambigüedades (por ejemplo, confundir la letra l minúscula con el número 1, o la letra O mayúscula con el número 0). El postprocesamiento utiliza diccionarios avanzados, modelos de lenguaje (LLM subyacentes) y análisis gramatical para corregir automáticamente estas confusiones basándose en el sentido de la oración.
Factores críticos que determinan el éxito de la extracción
No todas las imágenes son iguales ante los ojos de un motor de OCR. La tasa de éxito de la extracción depende directamente de una serie de variables físicas y digitales:
Resolución y nitidez: Una imagen de baja resolución carece de los píxeles suficientes para que el algoritmo distinga los bordes finos de los caracteres (como los remates o serifs de una tipografía clásica). Se recomienda idealmente una resolución mínima de 300 DPI (puntos por pulgada) para documentos escaneados.
Contraste cromático: Un texto negro sobre un fondo blanco puro ofrece la tasa de éxito más alta. Los textos claros sobre fondos oscuros o degradados complejos requieren algoritmos de binarización avanzados.
Tipografías y estilos: Las fuentes estándar (Arial, Times New Roman, Helvetica) son leídas con precisión casi perfecta. Las tipografías caligráficas, manuscritas artísticas, distorsionadas o con efectos tridimensionales suponen un reto mucho mayor que a menudo requiere modelos especializados de reconocimiento de escritura a mano (HTR, Handwritten Text Recognition).
Idiomas y alfabetos: Los motores deben estar configurados para el idioma correcto. Un motor configurado exclusivamente para español tendrá dificultades si encuentra caracteres especiales del alemán (ä, ö, ü, ß) o alfabetos no latinos (cirílico, árabe, devanagari, chino o japonés), aunque los modelos multimodales modernos han avanzado exponencialmente en este aspecto.
Herramientas líderes en el mercado para la extracción de texto (OCR)
Para llevar la teoría a la práctica de manera efectiva, es fundamental conocer cuáles son las herramientas más potentes y accesibles disponibles en la actualidad. El ecosistema tecnológico actual ofrece soluciones tanto para usuarios que buscan inmediatez en dispositivos móviles como para desarrolladores y empresas que requieren procesamiento masivo de documentos.
Google Lens y Google Keep
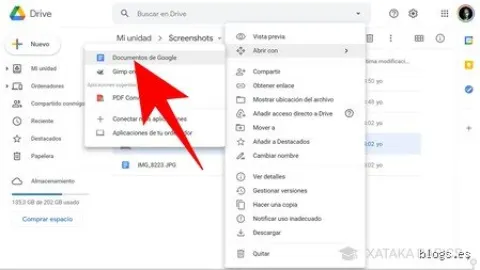
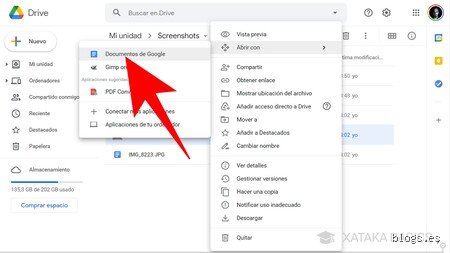
Para el día a día y tareas rápidas en dispositivos móviles o navegadores web, Google ofrece soluciones altamente optimizadas. Google Lens destaca por su capacidad de reconocer texto en tiempo real a través de la cámara del teléfono o desde cualquier imagen almacenada en la galería. Su integración con el ecosistema de Google permite copiar el texto con un solo toque, traducirlo instantáneamente a decenas de idiomas o enviarlo directamente a un ordenador vinculado. Por su parte, Google Keep permite subir imágenes con texto y utilizar la opción "Capturar texto de la imagen", convirtiendo la foto en una nota editable en cuestión de segundos.
Apple Live Text (texto en vivo)
Los usuarios de dispositivos Apple (iOS, iPadOS y macOS) cuentan con una herramienta nativa profundamente integrada en el sistema operativo llamada Live Text. Esta tecnología analiza de forma local y automática las fotografías, capturas de pantalla e incluso vídeos en pausa. Permite seleccionar, copiar, buscar y traducir texto directamente desde la aplicación de Fotos o la cámara sin necesidad de instalar aplicaciones de terceros, garantizando además un alto nivel de privacidad al procesar los datos directamente en el dispositivo.
Herramientas profesionales de escritorio: ABBYY FineReader y Adobe Acrobat
Cuando nos enfrentamos a volúmenes masivos de documentos físicos digitalizados (como libros antiguos, contratos complejos o archivos históricos con tipografías irregulares), las herramientas básicas se quedan cortas. ABBYY FineReader es el estándar de la industria para la conversión de documentos PDF y escaneados. Ofrece una precisión excepcional, herramientas de edición integradas, comparación de documentos y soporte para múltiples idiomas y alfabetos complejos. Adobe Acrobat Pro, por su tecnología Adobe Sensei, también proporciona capacidades de OCR robustas, ideales para flujoss de trabajo corporativos donde la fidelidad del formato original (tablas, columnas, fuentes) es crucial.
Soluciones basadas en la nube y APIs para desarrolladores
Para empresas que buscan automatizar procesos a gran escala, como la lectura automática de facturas, recibos o documentos de identidad, existen servicios en la nube altamente escalables:
Google Cloud Vision API: Ofrece un reconocimiento óptico de caracteres avanzado capaz de detectar texto impreso y escrito a mano en una amplia variedad de idiomas, optimizado para documentos densos y de baja calidad.
Amazon Textract: Va un paso más allá del OCR tradicional, ya que no solo extrae el texto, sino que comprende la estructura de los datos en formularios y tablas, extrayendo pares de clave-valor automáticamente.
Microsoft Azure Computer Vision: Proporciona modelos de IA punteros para la lectura rápida y precisa de texto en imágenes y documentos PDF pesados.
Cómo maximizar la precisión: Consejos para una extracción perfecta
Incluso con los algoritmos de Inteligencia Artificial más avanzados, la calidad del resultado final depende en gran medida de la calidad de la imagen de origen. Para evitar errores tipográficos y reducir el tiempo de corrección posterior, es recomendable seguir una serie de buenas prácticas durante la captura o el escaneo:
Iluminación uniforme y sin sombras: Evita brillos excesivos, reflejos de flash o sombras pronunciadas sobre el papel o la superficie que puedan confundir al algoritmo de contraste.
Enfoque nítido y alta resolución: Una imagen borrosa o pixelada genera ambigüedad en los caracteres (por ejemplo, confundir una letra "c" con una "e", o un "1" con una "l"). Asegúrate de que la cámara esté estable y el enfoque sea perfecto.
Ortogonalidad y alineación: Intenta capturar la imagen de frente y en paralelo al documento. Las distorsiones de perspectiva (fotografías tomadas desde un ángulo inclinado) deforman las líneas de texto y dificultan la lectura secuencial de los párrafos.
Preprocesamiento digital: Si trabajas con imágenes antiguas o escaneos de baja calidad, utilizar herramientas de edición fotográfica para ajustar el contraste, convertir a blanco y negro puro o eliminar el ruido de fondo puede marcar la diferencia entre un resultado inutilizable y una extracción perfecta.
Casos de uso prácticos en el entorno moderno
La versatilidad del OCR ha transformado la manera en que interactuamos con la información visual en múltiples sectores:
Educación e Investigación: Los estudiantes e investigadores utilizan la extracción de texto para digitalizar fragmentos de libros de la biblioteca, apuntes de pizarra o artículos impresos, permitiéndoles organizar sus notas en aplicaciones digitales y realizar búsquedas por palabras clave en segundos.
Gestión Financiera y Contable: La automatización de la lectura de tickets, facturas y comprobantes fiscales mediante OCR y Machine Learning ahorra cientos de horas de introducción manual de datos en las empresas.
Accesibilidad Universal: Las tecnologías de lectura de pantalla combinadas con OCR permiten a personas con discapacidad visual "leer" textos impresos en carteles, menús, etiquetas de productos y libros físicos a través de sus teléfonos inteligentes.
Traducción y Viajes: Al viajar al extranjero, fotografiar un cartel en un idioma desconocido y extraer/traducir el texto al instante elimina las barreras lingüísticas de forma inmediata.
Limitaciones actuales y el futuro del OCR
A pesar de los gigantescos avances logrados gracias al aprendizaje profundo (deep learning) y las redes neuronales convolucionales, el OCR todavía se enfrenta a ciertos desafíos específicos:
Caligrafía humana compleja: Mientras que la tipografía impresa es prácticamente infalible para las herramientas modernas, la escritura a mano alzada muy desordenada, cursivas extremas o estilos artísticos siguen presentando tasas de error significativas.
Contextos multilingües y tipografías híbridas: Documentos que mezclan alfabetos muy diversos (como latín, cirílico, kanjis japoneses o árabe) en una misma línea y con fuentes ornamentales pueden confundir a los motores menos especializados.
Sin embargo, el futuro apunta hacia modelos multimodales de Inteligencia Artificial capaces de "entender" el contexto semántico completo de la imagen. Esto significa que el sistema no solo reconocerá los glifos de forma aislada, sino que interpretará el significado global de la frase para corregir posibles errores de lectura en tiempo real.
En resumen
La respuesta a la pregunta inicial es un rotundo sí: hoy en día es no solo posible, sino extremadamente fácil, rápido y preciso extraer texto de una imagen. Gracias a la democratización de la tecnología, herramientas integradas en nuestros propios teléfonos móviles y plataformas profesionales en la nube permiten transformar cualquier captura visual en datos editables y manipulables.
Ya sea para simplificar tareas cotidianas, optimizar flujos de trabajo profesionales o mejorar la accesibilidad, dominar estas herramientas se ha convertido en una habilidad esencial en el mundo digital actual. La próxima vez que te encuentres frente a una imagen con información valiosa, no necesitas reescribirla a mano: la tecnología está lista para hacerlo por ti.