❤️ Familia y relaciones Hijos y crianza
¿Cómo Copiar texto de una imagen en PC?
Respuesta corta
¿Alguna vez te has encontrado frente a una pantalla de ordenador mirando una infografía fascinante, un documento escaneado en formato PDF antiguo o una diapositiva clave de una conferencia universitaria, experimentando esa frustrante sensación de impotencia al intentar seleccionar el texto con el cursor y comprobar que absolutamente nada se mueve?
En este artículo
La paradoja visual del siglo XXI: cuando la información está atrapada en pixeles
Desentrañando el misterio: ¿Qué es exactamente la tecnología OCR y por qué cambió las reglas del juego?
Para comprender a fondo cómo superar esta barrera digital, resulta indispensable adentrarse en los cimientos tecnológicos que lo hacen posible. Históricamente, las computadoras procesaban las imágenes como simples colecciones de pixeles de colores sin la menor capacidad analítica sobre su contenido semántico. Sin embargo, gracias a los avances monumentales en la inteligencia artificial y el procesamiento digital de señales, hoy en día disponemos del sistema OCR (por sus siglas en inglés, Optical Character Recognition o Reconocimiento Óptico de Caracteres). Esta sofisticada herramienta opera mediante algoritmos capaces de escanear minuciosos patrones geométricos, curvas, trazos y espacios en blanco dentro de una fotografía digital, interpretándolos con asombrosa precisión para convertirlos en caracteres tipográficos reales que cualquier procesador de textos puede reconocer, modificar y almacenar.
A continuación, examinaremos los motivos principales que justifican la adopción de estos métodos avanzados en nuestras rutinas informáticas:
Eficiencia temporal: Evita por completo la tediosa tarea de transcribir manualmente largos párrafos letra por letra, reduciendo el margen de error humano a cero.
Accesibilidad universal: Permite que usuarios con dificultades visuales utilicen lectores de pantalla sobre contenidos que originalmente eran inaccesibles por estar incrustados en gráficos.
Optimización de archivos: Facilita enormemente la indexación y búsqueda de palabras clave dentro de archivos de imagen archivados en discos duros locales o servicios en la nube.
Versatilidad académica y laboral: Agiliza drásticamente la recopilación de datos bibliográficos procedentes de libros escaneados o apuntes compartidos en redes sociales.
Evolución histórica: Del reconocimiento matricial rudimentario a la inteligencia artificial actual
Adicionalmente, vale la pena señalar que esta tecnología no surgió de la noche a la mañana. En sus albores tecnológicos (durante las décadas de 1970 y 1980), los sistemas de reconocimiento dependían exclusivamente de fuentes tipográficas predefinidas y plantillas rígidas (un método conocido como reconocimiento de patrones matriciales). En consecuencia, si un documento presentaba la más mínima deformación, una fuente poco convencional o manchas de tinta, el software fallaba estrepitosamente. No obstante, con la llegada de las redes neuronales profundas y el aprendizaje automático (machine learning), las herramientas actuales aprenden continuamente de millones de muestras lingüísticas multilingües. Así pues, hoy en día es perfectamente viable extraer texto escrito a mano alzada o tipografías ornamentales complejas con tasas de acierto que superan el noventa y cinco por ciento.
Panorama actual en los sistemas operativos de PC: Soluciones integradas frente a alternativas de terceros
Por otra parte, es fundamental destacar que el usuario contemporáneo ya no necesita instalar pesados programas especializados o recurrir a costosas licencias de software privativo para lograr este propósito. En la actualidad, tanto los sistemas operativos dominantes como los navegadores web modernos incorporan de serie potentes motores de extracción de texto. Por un lado, herramientas nativas como la herramienta Recortes en Windows (provista de la funcionalidad de "Acciones de texto") permiten realizar capturas y extraer su contenido de forma instantánea sin intermediarios. Por otro lado, ecosistemas alternativos ofrecen extensiones y plataformas basadas en la nube que amplían exponencialmente las posibilidades de conversión masiva (por ejemplo, procesando carpetas enteras de archivos PDF escaneados en cuestión de segundos).
En consecuencia, el dominio de estas técnicas representa una ventaja competitiva innegable. Ya sea que necesites rescatar una cita célebre de un meme inspirador, digitalizar apuntes manuscritos o extraer datos numéricos complejos de una tabla contenida en un gráfico corporativo, comprender el funcionamiento de estas herramientas te ahorrará horas de esfuerzo improductivo. En la siguiente sección de este artículo especializado, profundizaremos paso a paso en los métodos prácticos más eficientes disponibles actualmente para usuarios de PC.
...(Continuación de la guía experta sobre cómo extraer texto de imágenes en PC).
Método 3: Google Drive y Google Docs (La alternativa web universal)
Si prefieres no instalar ningún software adicional en tu ordenador y buscas una solución basada completamente en la nube, la combinación de Google Drive y Google Docs ofrece un motor OCR (Reconocimiento Óptico de Caracteres) extremadamente potente y gratuito. Este método es ideal para textos largos, documentos escaneados en formato PDF o imágenes con fuentes complejas.
Pasos para extraer texto con Google Drive
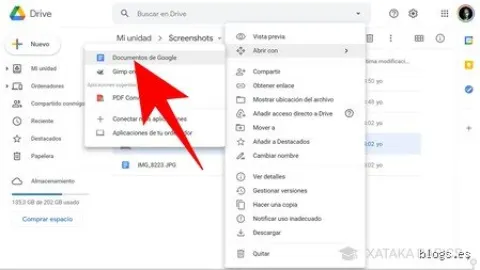
Sube la imagen: Abre tu navegador web, entra en Google Drive y arrastra la imagen (o haz clic en el botón Nuevo > Subir archivo) para guardarla en tu unidad.
Abre con Google Docs: Haz clic derecho sobre la imagen ya subida dentro de Google Drive, selecciona Abrir con y elige Google Docs.
Espera el procesamiento: Google abrirá un nuevo documento de texto. En la parte superior aparecerá la imagen original y, justo debajo, todo el texto extraído automáticamente por el algoritmo de Google.
Edita y exporta: El texto editable estará listo para ser corregido, copiado y pegado en cualquier otro procesador de textos como Microsoft Word o Bloc de notas.
Ventaja principal: No requiere instalaciones y funciona con cualquier sistema operativo (Windows, macOS o Linux) siempre que tengas un navegador moderno. Es excelente para manejar archivos multilingües gracias al respaldo de Google Translate.
Método 4: Microsoft OneNote y su motor OCR integrado
Para los usuarios que utilizan la suite de Microsoft Office habitualmente, OneNote es una herramienta tradicional pero sumamente eficaz para capturar texto de imágenes sin depender de conexiones a internet constantes.
Pasos para utilizar OneNote
Abre la aplicación OneNote en tu PC con Windows.
Inserta la imagen en una página en blanco (puedes arrastrarla o ir a Insertar > Imágenes).
Haz clic derecho directamente sobre la imagen insertada en el bloc de notas.
Del menú contextual que aparece, selecciona la opción Copiar texto de la imagen (Copy Text from Picture).
Coloca el cursor donde desees el texto y presiona Ctrl + V para pegarlo.
Nota técnica: Aunque OneNote es rápido, su precisión puede disminuir notablemente si la imagen tiene fondos texturizados o fuentes artísticas muy estilizadas.
Método 5: herramientas online y extensiones de navegador
Cuando te enfrentas a imágenes alojadas directamente en páginas web (por ejemplo, infografías, infografías protegidas o capturas en foros) y no quieres descargar el archivo a tu ordenador, las extensiones de navegador son la solución más eficiente.
Project Naptha (para Google Chrome): Es una extensión