❤️ Familia y relaciones Hijos y crianza
¿Cómo colocar una imagen en AI?
Guía Definitiva: Cómo Colocar e Integrar Imágenes en Inteligencia Artificial
Respuesta corta
Si te has preguntado alguna vez cómo colocar una imagen en una IA, el proceso va mucho más allá de simplemente arrastrar un archivo a una ventana de chat.
En pocas palabras
- Para entender cómo colocar e interactuar con imágenes en una plataforma de inteligencia artificial, primero debemos comprender qué ocurre bajo el capó cuando un modelo recibe una imagen.
- No todas las interacciones con imágenes tienen el mismo propósito ni utilizan las mismas tecnologías subyacentes.
- El método más común para el usuario promedio y profesional es la incorporación de imágenes en asistentes conversacionales.
- Colocar una imagen por sí sola a menudo no es suficiente para obtener un resultado experto.
- En esta primera sección hemos sentado las bases teóricas de la multimodalidad, los tipos de integración visual y los estándares técnicos para incorporar imágenes en asistentes conversacionales.
En este artículo
- El paradigma de la IA multimodal: ¿cómo "ve" una máquina?
- Tipos de interacción: ¿para qué quieres colocar una imagen en la IA?
- Cómo subir y colocar imágenes en modelos de lenguaje (LLMs)
- Mejores prácticas de preparación y contexto (prompting visual)
- Próximos Pasos
- Técnicas avanzadas: control espacial y estilístico (Image-to-Image y ControlNet)
- Edición quirúrgica: inpainting y outpainting
- Optimización del prompt multimodal (texto + imagen)
- Errores comunes y cómo evitarlos
- Conclusión y el futuro de la interacción visual
Si te has preguntado alguna vez cómo colocar una imagen en una IA, el proceso va mucho más allá de simplemente arrastrar un archivo a una ventana de chat. Involucra comprender cómo los modelos interpretan los píxeles, qué metodologías existen según el objetivo que persigas (análisis, edición, generación Image-to-Image o control estructural avanzado) y cuáles son las mejores prácticas técnicas para maximizar los resultados.
El paradigma de la IA multimodal: ¿cómo "ve" una máquina?
Para entender cómo colocar e interactuar con imágenes en una plataforma de inteligencia artificial, primero debemos comprender qué ocurre bajo el capó cuando un modelo recibe una imagen.
A diferencia de los seres humanos, que interpretan el entorno mediante un sistema biológico complejo de percepción visual y cognición, las redes neuronales artificiales (específicamente las arquitecturas basadas en Vision Transformers - ViT y redes convolucionales - CNN) procesan las imágenes convirtiéndolas en representaciones matemáticas de alta dimensión.
Segmentación y Tokens Visuales: Cuando cargas una imagen en un modelo multimodal (como GPT-4o, Claude 3.5 Sonnet o Google Gemini), el sistema divide la imagen en una cuadrícula de pequeños parches o regiones (análogos visuales a los tokens de texto).
Incrustaciones Vectoriales (Embeddings): Cada parche visual se transforma en un vector numérico que captura características cromáticas, texturas, formas geométricas y relaciones espaciales.
Fusión Multimodal: Estos vectores visuales se alinean en el mismo espacio de embedding que el texto. De este modo, la red neuronal puede "leer" la imagen y relacionarla directamente con las instrucciones escritas (prompts) que le acompañan.
Esta integración fluida permite realizar tareas tan diversas como extraer texto de una factura escaneada, diagnosticar anomalías en una radiografía médica, corregir código fuente a partir de una captura de pantalla o describir detalladamente el estilo artístico de una pintura renacentista.
Tipos de interacción: ¿para qué quieres colocar una imagen en la IA?
No todas las interacciones con imágenes tienen el mismo propósito ni utilizan las mismas tecnologías subyacentes. Al hablar de "colocar una imagen en la IA", debemos clasificar el flujo de trabajo en tres grandes categorías profesionales:
┌─────────────────────────────────────────────────────────────────┐
│ TIPOS DE INTEGRACIÓN VISUAL │
├──────────────────────────┬──────────────────────────────────────┤
│ 1. Análisis y Comprensión│ La IA actúa como observador/experto │
│ 2. Image-to-Image │ La IA toma una imagen como inspiración│
│ 3. Control Estructural │ Guía milimétrica de formas y poses │
└──────────────────────────┴──────────────────────────────────────┘
A. Análisis, auditoría y comprensión visual (Vision-Language models)
En este escenario, utilizas la imagen como fuente de información para que el modelo la analice, responda preguntas sobre ella, extraiga datos o critique su diseño.
Casos de uso: Analizar gráficos financieros, revisar wireframes de interfaz de usuario (UI/UX), traducir texto manuscrito, o evaluar la composición fotográfica.
Herramientas principales: ChatGPT (OpenAI), Claude (Anthropic), Gemini (Google).
B. Generación basada en imagen (Image-to-Image y estilo)
Aquí empleas una imagen inicial como punto de partida o semilla creativa para que un generador de imágenes (como Midjourney, Stable Diffusion o DALL-E) cree una nueva versión modificada o estilizada.
Casos de uso: Transformar un boceto a lápiz en una renderización arquitectónica fotorrealista, cambiar la iluminación de una fotografía o fusionar dos estilos visuales.
Herramientas principales: Midjourney (/imagine con parámetro de imagen y --iw), Stable Diffusion (pestaña Img2Img), Leonardo.ai.
C. Control estructural avanzado (ControlNet y guías de composición)
Es el nivel más avanzado en la generación sintética. Permite extraer mapas de profundidad (Depth Maps), líneas de borde (Canny), esqueletos de pose (OpenPose) o segmentaciones semánticas para obligar a la IA a respetar milimétricamente la estructura de la imagen original mientras genera contenido nuevo.
Casos de uso: Generar personajes manteniendo exactamente la misma pose corporal, o recrear un interior manteniendo la distribución exacta de los muebles.
Herramientas principales: Stable Diffusion (con extensiones ControlNet o IP-Adapter), ComfyUI.
Cómo subir y colocar imágenes en modelos de lenguaje (LLMs)
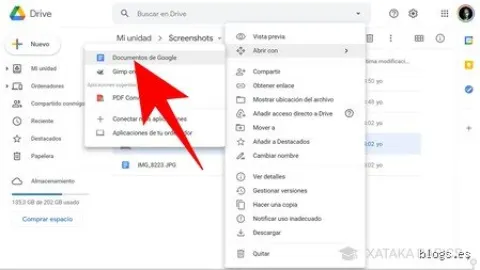
El método más común para el usuario promedio y profesional es la incorporación de imágenes en asistentes conversacionales. A continuación, detallamos el procedimiento estándar y las especificaciones técnicas para garantizar que el modelo procese tu archivo sin errores.
Formatos de archivo soportados
La gran mayoría de los modelos modernos admiten los formatos estándar de la industria web:
JPEG / JPG: Ideal para fotografías y capturas con compresión estándar.
PNG: Recomendado para capturas de pantalla, infografías, diagramas y gráficos donde la nitidez de los bordes y el texto es crucial.
WEBP: Ampliamente soportado por su alta eficiencia de compresión.
GIF (estático): Soportado en la mayoría de plataformas, aunque las animaciones complejas suelen ser convertidas a fotogramas individuales o ignoradas parcialmente según el modelo.
Límites de tamaño y resolución
Aunque las plataformas realizan una compresión o redimensionamiento interno automático para optimizar el consumo de tokens y memoria de video (VRAM), enviar archivos excesivamente pesados (mayores a 20 MB o con resoluciones 8K masivas) puede provocar errores de carga o tiempos de espera prolongados.
Recomendación óptima: Trabajar con resoluciones entre 1080p y 2K (por ejemplo, 1920x1080 píxeles), lo cual ofrece un balance perfecto entre detalle visual legible para la IA y velocidad de procesamiento.
Mejores prácticas de preparación y contexto (prompting visual)
Colocar una imagen por sí sola a menudo no es suficiente para obtener un resultado experto. El secreto radica en acompañar el archivo visual con instrucciones contextuales precisas y estructuradas.
Claridad y Enfoque: Asegúrate de que el sujeto principal de la imagen esté bien iluminado, sin obstrucciones innecesarias ni ruido visual excesivo, a menos que el propósito sea precisamente analizar dicho ruido.
Instrucciones Explícitas: En lugar de subir una imagen y escribir "¿Qué ves aquí?", define el rol y la tarea exacta del modelo.
Ejemplo deficiente: "Mira esta foto."
Ejemplo experto: "Actúa como un director de arte senior. Analiza la paleta de colores, la iluminación de tres puntos y la composición de regla de tercios en esta fotografía, y sugiere tres mejoras específicas para elevar su impacto comercial."
Uso de Múltiples Imágenes: Los modelos actuales permiten subir secuencias de imágenes simultáneamente. Esto es extremadamente útil para realizar comparaciones de antes/después, mostrar variaciones de un diseño o aportar múltiples perspectivas de un mismo objeto físico.
Próximos Pasos
En esta primera sección hemos sentado las bases teóricas de la multimodalidad, los tipos de integración visual y los estándares técnicos para incorporar imágenes en asistentes conversacionales.
Técnicas avanzadas: control espacial y estilístico (Image-to-Image y ControlNet)
Una vez que dominas la inserción básica de referencias visuales, el siguiente nivel en la integración de imágenes con Inteligencia Artificial radica en el uso de técnicas avanzadas como Image-to-Image (Img2Img) y redes de control como ControlNet. Estas metodologías permiten ir mucho más allá de una simple inspiración estética, otorgando un dominio milimétrico sobre la estructura, la composición y los trazos finales.
El flujo de trabajo en Image-to-Image
El proceso de Img2Img toma una imagen existente y la utiliza como el "punto de partida" o semilla visual sobre la cual el modelo de difusión comienza a generar ruido y a reconstruir los nuevos píxeles.
Denoising Strength (Fuerza de Desenfoque/Denoising): Es el parámetro crucial en este flujo. Si se configura con un valor bajo (por ejemplo, 0.2), la IA respetará casi al pie de la letra la imagen original, limitándose a pulir detalles o cambiar ligeras texturas. Si se eleva a un valor alto (0.8 o superior), la estructura base servirá apenas como una sugerencia vaga y el modelo tendrá libertad creativa casi total.
Aplicaciones prácticas: Es ideal para transformar bocetos a lápiz en ilustraciones fotorrealistas, renderizar planos arquitectónicos en acabados fotorrealistas o cambiar por completo el estilo artístico de una fotografía (por ejemplo, convertir una foto urbana en una pintura al óleo estilo renacentista).
ControlNet: La precisión geométrica definitiva
Cuando el Img2Img tradicional resulta insuficiente porque necesitas que la postura de un personaje, la perspectiva de una habitación o los contornos de un objeto se mantengan exactamente iguales, entra en juego ControlNet.
ControlNet añade redes neuronales auxiliares al modelo base para condicionar la generación mediante mapas estructurados:
OpenPose: Detecta la esqueleto y las articulaciones de una persona en la imagen de referencia para replicar exactamente la misma postura en el personaje generado por la IA.
Canny / Depth: Extraen los bordes o la profundidad espacial de una escena fotográfica, garantizando que la perspectiva tridimensional y los contornos de los objetos se preserven con precisión quirúrgica.
Lineart / Scribble: Permiten alimentar a la plataforma con trazos hechos a mano alzada y convertirlos en composiciones complejas sin perder la esencia del diseño original.
Edición quirúrgica: inpainting y outpainting
La capacidad de colocar una imagen en la IA no se limita a transformar todo el archivo; las herramientas modernas permiten intervenir fragmentos específicos mediante dos técnicas fundamentales: Inpainting y Outpainting.
Inpainting (relleno inteligente)
El Inpainting consiste en enmascarar (brushing) una zona específica de la imagen original para indicarle a la IA qué área debe modificar o regenerar, manteniendo intacto el resto del lienzo.
Casos de uso: Eliminar un objeto no deseado, corregir una deformidad anatómica en una mano o rostro, cambiar una prenda de vestir sin alterar el fondo, o añadir elementos nuevos (como un sombrero o unas gafas de sol) de manera perfectamente integrada con la iluminación y las sombras preexistentes.
Consejo experto: Al escribir el prompt para el área seleccionada, describe únicamente el objeto nuevo o la modificación deseada, asegurándote de que el contexto coincida con la paleta de colores y la iluminación general de la imagen base.
Outpainting (expansión de lienzo)
A la inversa del inpainting, el outpainting amplía los límites físicos de la imagen hacia afuera. La IA analiza los bordes existentes y extrapola el contenido para rellenar el espacio vacío de manera coherente.
Casos de uso: Convertir una imagen cuadrada en un formato panorámico (16:9), extender un paisaje urbano o añadir más cielo y terreno a un retrato fotográfico.
Clave de éxito: Mantén la consistencia en el estilo visual seleccionando el mismo modelo de generación y asegurándote de que los fundidos en las uniones sean imperceptibles.
Optimización del prompt multimodal (texto + imagen)
En los sistemas actuales de generación de imágenes multimodales (como las iteraciones avanzadas de Midjourney, DALL-E y Stable Diffusion), la combinación de texto e imagen (Image Prompts) requiere un equilibrio métrico para evitar conflictos de información.
[Imagen de Referencia] + [Modificadores de Estilo] + [Descripción Textual de Cambios] = Resultado Óptimo
Factores de ponderación y relación de aspecto
Peso de la imagen (--iw en Midjourney): Este parámetro controla qué tanto peso tiene la referencia visual frente al texto descriptivo. Un valor alto prioriza los colores, la paleta y la composición de la imagen aportada, mientras que un valor bajo le da mayor protagonismo al prompt en texto.
Resolución y Relación de Aspecto: Al colocar una imagen en la IA, es altamente recomendable que su relación de aspecto (aspect ratio) sea cercana a la del formato final que deseas obtener. Forzar a un modelo a estirar drásticamente una imagen vertical hacia un formato horizontal suele introducir artefactos visuales y distorsiones indeseadas.
Errores comunes y cómo evitarlos
Incluso con las mejores herramientas, es fácil cometer errores metodológicos que reducen la calidad del resultado final:
Usar imágenes con ruido o baja resolución: Alimentar al sistema con capturas de pantalla borrosas o comprimidas genera artefactos en la IA. Utiliza siempre archivos limpios en formatos de alta calidad (PNG o JPEG de alta resolución).
Ignorar la consistencia de la iluminación: Si insertas un elemento u objeto externo en una imagen mediante Inpainting o composición, verifica que la dirección de la luz en el prompt coincida con la fuente lumínica de la escena original.
Sobrecargar el prompt de texto: Cuando utilizas una imagen de referencia muy detallada, el texto debe ser complementario y conciso. Describir nuevamente elementos que ya son evidentes en la imagen puede confundir al algoritmo.
Conclusión y el futuro de la interacción visual
Colocar una imagen en una Inteligencia Artificial ha dejado de ser un proceso experimental y de prueba y error para convertirse en un estándar profesional de la dirección creativa y el diseño digital. Ya sea mediante Image-to-Image, controles geométricos avanzados como ControlNet o ediciones quirúrgicas con Inpainting, el control sobre los resultados es hoy más preciso que nunca.
A medida que los modelos multimodales continúan evolucionando hacia una comprensión más profunda de la física, la semántica y la intención humana, la sinergia entre el criterio artístico del creador y la capacidad de procesamiento de la IA redefine los límites de la imaginación visual. Dominar estas técnicas te posiciona no solo como un espectador de la tecnología, sino como un director activo en la creación del futuro digital.