❤️ Familia y relaciones Hijos y crianza
¿Cómo puedo detectar si un audio es IA?
Respuesta corta
La evolución de la inteligencia artificial generativa ha alcanzado un punto de inflexión sin precedentes.
En este artículo
- La revolución silenciosa: cómo detectar audios generados por inteligencia artificial en la era de los deepfakes vocales
- Análisis espectral y espectrogramas: la perspectiva técnica avanzada
- Herramientas y software de detección profesional
- Factores contextuales y verificación cruzada (OSINT)
- El futuro de la detección y la conciencia digital
- Entonces, ¿qué hacer?
La revolución silenciosa: cómo detectar audios generados por inteligencia artificial en la era de los deepfakes vocales
Este avance tecnológico, aunque abre un abanico fascinante de aplicaciones legítimas en industrias como la locución comercial, el doblaje cinematográfico automatizado, los asistentes virtuales hiperpersonalizados y la accesibilidad para personas con trastornos del habla, también ha inaugurado una era de vulnerabilidad digital sin precedentes. Los ciberdelincuentes, estafadores y actores maliciosos de diversa índole aprovechan estos sistemas para perpetrar fraudes financieros sofisticados mediante suplantación de identidad (conocidos en inglés como audio deepfakes o vishing sintético), manipular procesos electorales, dañar reputaciones corporativas o personales a través de difamaciones falsas y ejecutar estafas de ingeniería social a escala global.
Frente a este panorama, la capacidad de discernir con rigor técnico y analítico si una grabación de voz es auténtica o ha sido fabricada artificialmente ya no es una competencia exclusiva de laboratorios forenses digitales de agencias de inteligencia: se ha convertido en una necesidad imperativa para periodistas, profesionales de la ciberseguridad, empresas y ciudadanos de a pie.
El panorama tecnológico: ¿cómo funciona la síntesis de voz moderna?
Para entender cómo detectar un audio generado por inteligencia artificial, resulta fundamental comprender primero la naturaleza de la tecnología subyacente. Los sistemas actuales de conversión de texto a voz (Text-to-Speech o TTS) y de conversión de voz a voz (Voice Conversion) no operan mediante la simple concatenación de sílabas grabadas estáticamente, como ocurría en los sistemas robóticos de generaciones pasadas. Utilizan modelos de aprendizaje profundo entrenados con enormes bases de datos acústicas que descomponen la voz humana en múltiples capas de representación paramétrica.
Modelos de difusión y vocoders neuronales
Los sistemas modernos se dividen típicamente en dos grandes etapas:
El generador semántico y acústico: Interpreta el texto o la señal de entrada y predice representaciones intermedias, como espectrogramas de Mel, que capturan cómo cambia la energía de las frecuencias a lo largo del tiempo.
El vocoder neuronal (por ejemplo, modelos basados en WaveNet, HiFi-GAN o arquitectura de difusión): Toma esas representaciones intermedias y reconstruye la forma de onda de audio de alta fidelidad, generando muestras de audio a 22kHz o 44kHz.
Es precisamente en este proceso de reconstrucción donde los algoritmos suelen dejar "huellas digitales" o artefactos invisibles al oído humano desprevenido, pero perfectamente identificables mediante análisis espectral y auditivo especializado.
Indicadores acústicos y lingüísticos: el análisis humano inicial
Antes de recurrir a herramientas de software automatizadas, el oído humano entrenado —combinado con un análisis crítico del contexto— puede identificar señales de alerta (red flags) inequívocas en una grabación sospechosa. Aunque los modelos de IA son cada vez más sofisticados, todavía luchan por replicar con absoluta perfección la complejidad biológica y psicológica del habla humana natural.
A. Anomalías en la respiración y las pausas fisiológicas
Los seres humanos no hablamos de manera continua como un flujo ininterrumpido de datos; nuestra emisión vocal está supeditada a nuestras necesidades biológicas y cognitivas.
Ausencia o artificialidad de las inhalaciones: En un discurso humano natural, especialmente cuando se habla con cierta extensión o pasión, se producen micro-pausas destinadas a la toma de aire (inhalaciones nasales o bucales sutiles pero perceptibles). Los generadores de IA a menudo omiten por completo estas respiraciones o insertan sonidos de aire que suenan idénticos, mecánicamente repetitivos y desvinculados del ritmo de la frase.
Pausas cognitivas anómalas: Cuando improvisamos, los humanos utilizamos muletillas ("eh", "este", "mhm") y realizamos pausas de planificación mientras pensamos en el siguiente concepto. La IA tiende a generar discursos con una fluidez sintáctica y temporal perfecta pero robótica, o bien inserta pausas en lugares gramaticalmente incorrectos (por ejemplo, dividiendo un sintagma nominal en dos de forma antinatural).
B. Artefactos de pronunciación y coarticulación
La coarticulación es el fenómeno lingüístico mediante el cual los órganos articulatorios (lengua, labios, velo del paladar) se anticipan o se adaptan a los sonidos circundantes en una palabra.
Falta de transiciones fluidas: Los modelos de IA basados en la concatenación de fragmentos estocásticos a veces fallan en suavizar las transiciones entre fonemas complejos (como grupos consonánticos trabados, por ejemplo, "transporte" o "espléndido"), generando microcortes, chasquidos metálicos o distorsiones sutiles en las consonantes fricativas (/s/, /f/, /z/) y oclusivas (/p/, /t/, /k/).
Entonación aplanada o prosodia robótica: Aunque los modelos actuales manejan la entonación emocional, en discursos largos tienden a mostrar una ligera monotonía en la curva melódica (la variación del tono fundamental o F0F_0F0), perdiendo la naturalidad de los picos de énfasis emocional genuino.
El espectrograma: la radiografía del sonido
Cuando el análisis auditivo no es suficiente, la herramienta definitiva para un experto es el espectrograma. Se trata de una representación visual de un espectro de frecuencias de una señal de audio a medida que esta varía con el tiempo. El eje horizontal representa el tiempo, el eje vertical representa la frecuencia (desde los graves hasta los agudos) y el color o brillo indica la amplitud o intensidad de cada frecuencia en un momento dado.
Qué buscar en un espectrograma de IA
Cortes abruptos de alta frecuencia: Muchos vocoders neuronales económicos o mal optimizados presentan un límite superior estricto en las frecuencias (por ejemplo, un corte limpio y horizontal exacto en los 12 kHz o 16 kHz), mientras que la voz humana real contiene energía distribuida de manera orgánica y difusa hacia los rangos ultra-altos.
Patrones repetitivos y artefactos de fase: Los algoritmos basados en redes convolucionales a veces dejan patrones de textura geométrica repetitiva o bandas difusas horizontales inusuales en zonas de frecuencias medias-altas que no corresponden con formantes vocales humanos naturales.
Análisis espectral y espectrogramas: la perspectiva técnica avanzada
Cuando las anomalías perceptuales (como las pausas extrañas o la fatiga en la entonación) no son suficientes para emitir un veredicto definitivo, los expertos forenses recurren al análisis técnico del archivo de audio mediante espectrogramas. Un espectrograma es una representación visual de un espectro de frecuencias de una señal acústica a lo largo del tiempo, donde el eje horizontal representa el tiempo, el vertical representa la frecuencia y el brillo o color indica la amplitud (intensidad) de cada frecuencia.
Anomalías en las altas frecuencias
Los modelos de aprendizaje automático generativo (como los basados en redes neuronales profundas y vocoders neuronales avanzados del tipo HiFi-GAN o WaveNet) a menudo se entrenan y optimizan para replicar el rango de frecuencia en el que opera la voz humana conversacional (generalmente por debajo de los 8 kHz). Sin embargo, al sintetizar audio en alta definición, suelen presentar patrones característicos que delatan su origen sintético:
Cortes abruptos (Cut-offs): En muchas grabaciones generadas por IA, al observar el espectrograma se nota un límite horizontal muy definido más allá del cual las frecuencias superiores desaparecen por completo o muestran un ruido blanco artificial y uniforme. Las grabaciones de voz humanas reales capturadas con micrófonos de calidad suelen mostrar una caída de energía más orgánica y gradual en las altas frecuencias, o bien ruido ambiental constante de fondo que se extiende de manera natural.
Falta de armónicos naturales en los formantes superiores: La voz humana genera una compleja red de armónicos y formantes que varían dinámicamente debido a la resonancia de la caja torácica, la faringe y la cavidad nasal. Las IA tienden a promediar estos valores, lo que en un espectrograma se traduce en bandas de frecuencia excesivamente estáticas o "suavizadas", carentes de la microvariabilidad natural del tracto vocal humano.
Artefactos de fase y artefactos de reconstrucción: Los vocoders a menudo dejan pequeños patrones geométricos repetitivos (a veces denominados "mosaicos" visuales en el espectrograma) debido a la forma en que reconstruyen las ondas de audio a partir de representaciones en el dominio de la frecuencia (espectrogramas de Mel).
Herramientas y software de detección profesional
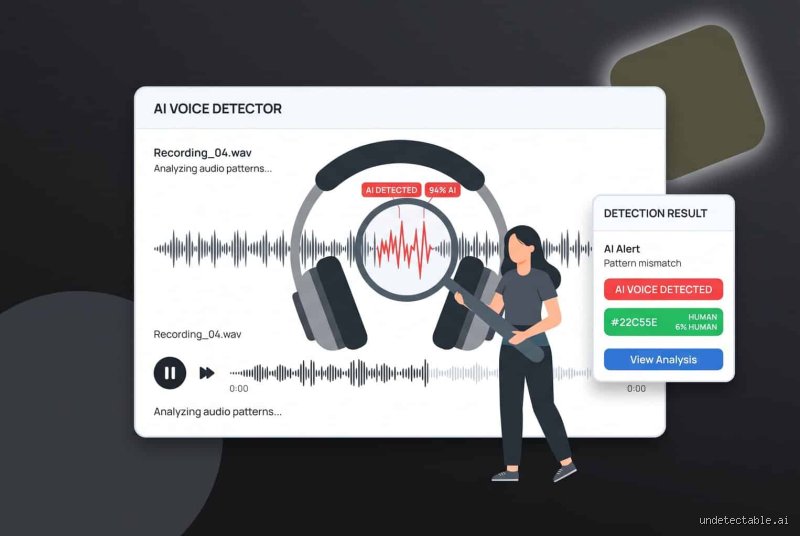
Para los usuarios que no disponen de software de edición de audio avanzado ni de conocimientos en acústica forense, la industria tecnológica ha desarrollado herramientas automatizadas especializadas en la detección de deepfakes de audio. Estas plataformas emplean redes neuronales discriminatorias entrenadas con vastas bases de datos de audios reales y sintéticos.
Tipos de herramientas disponibles
Plataformas de Detección en la Nube: Servicios especializados analizan la huella digital del archivo de audio subido, examinando la entropía, las discontinuidades de fase y los patrones característicos de compresión. Estas herramientas devienen especialmente útiles para periodistas, investigadores y departamentos de recursos humanos expuestos a fraudes de suplantación de identidad por voz (vishing).
Extensiones y Software de Análisis en Tiempo Real: En entornos de ciberseguridad corporativa y centros de llamadas (call centers), ya se implementan pasarelas de voz capaces de analizar el flujo de audio entrante en milisegundos para alertar a los operadores si la voz del interlocutor muestra indicios matemáticos de estar siendo generada o modificada sintéticamente.
Limitaciones actuales de los detectores automáticos
Es crucial entender que ninguna herramienta de detección es infalible al 100%. Los sistemas de IA generativa evolucionan a un ritmo vertiginoso; a medida que los detectores aprenden a identificar un fallo específico (por ejemplo, la falta de respiraciones), los desarrolladores de modelos actualizan sus algoritmos de síntesis para imitar esos mismos comportamientos biológicos. Por esta razón, los expertos recomiendan utilizar los detectores automatizados únicamente como una capa adicional de apoyo dentro de un proceso de verificación más amplio.
Factores contextuales y verificación cruzada (OSINT)
Ante la sofisticación actual de los sintetizadores de voz, el análisis puramente técnico del audio a menudo debe complementarse con una investigación de fuentes abiertas (OSINT por sus siglas en inglés) y un análisis del contexto socio-político o corporativo en el que aparece la grabación.
La Regla de la Extrañeza Contextual: Pregúntese siempre: ¿Tiene sentido que esta persona haya dicho esto, en este momento y bajo estas circunstancias? Con frecuencia, los audios falsificados se diseñan específicamente para provocar una reacción visceral (indignación, sorpresa, miedo o euforia). Si una figura pública hace una declaración explosiva o controvertida exclusivamente a través de un clip de audio anónimo en redes sociales, sin cobertura previa de medios de comunicación acreditados, el nivel de escepticismo debe ser máximo.
Rastreo de la Fuente Primaria: Siga la pista del archivo hasta su origen absoluto. ¿Quién subió el archivo por primera vez? ¿Es una cuenta verificado? ¿Existen múltiples ángulos o grabaciones del mismo evento desde perspectivas independientes? Si se trata de una llamada telefónica filtrada, verifique si los canales oficiales de la organización involucrada han emitido comunicados al respecto.
Estándares de Trazabilidad (C2PA y Marcas de Agua): A nivel internacional, consorcios tecnológicos y de medios están implementando estándares criptográficos como la Coalition for Content Provenance and Authenticity (C2PA). Estos estándares añaden metadatos inalterables y marcas de agua digitales seguras directamente en el archivo multimedia desde el momento de su captura en dispositivos compatibles, permitiendo certificar si un contenido ha sido alterado o generado algorítmicamente.
El futuro de la detección y la conciencia digital
Nos encontramos en una carrera armamentística tecnológica constante entre la capacidad de generar engaños hiperrealistas y la capacidad de desarrollar contramedidas para detectarlos. Si bien la tecnología de clonación de voz se ha democratizado hasta el punto de que cualquier usuario puede replicar una voz con apenas unos segundos de muestra, la conciencia pública y la educación digital también están evolucionando.
La clave para mitigar el impacto de los deepfakes de audio no recae únicamente en la tecnología de detección automática, sino en la adopción de una cultura general de escepticismo informado. Así como aprendimos a desconfiar de las fotografías retocadas digitalmente a finales del siglo XX y de las noticias falsas en formato texto durante la década pasada, la era actual exige que desarrollemos un "oído crítico" ante cualquier archivo de audio que carezca de una cadena de custodia verificable.
Entonces, ¿qué hacer?
Detectar si un audio ha sido generado o manipulado por Inteligencia Artificial ya no es una tarea exclusiva de los laboratorios de criminalística forense; se ha convertido en una habilidad de alfabetización digital indispensable para cualquier ciudadano conectado.
Para protegerse eficazmente, recuerde aplicar una estrategia multifactorial:
Escuche con atención analítica buscando la ausencia de microvariaciones biológicas (respiraciones, pausas naturales, fatiga vocal).
Analice las inconsistencias acústicas y de contenido (coherencia en el eco, la reverberación y las transiciones de palabras).
Valide el contexto y la fuente mediante la verificación cruzada con medios confiables.
Utilice herramientas de apoyo técnico cuando se requiera un dictamen especializado sobre archivos sospechosos.
La tecnología de IA continuará perfeccionándose, pero mantenernos alerta, informados y metódicos es nuestra mejor defensa para preservar la verdad y la confianza en la comunicación humana.