🔬 Ciencia y naturaleza Inventos y descubrimientos
¿Cuáles son los métodos probabilísticos?
Los Métodos Probabilísticos: Fundamentos, Arquitectura Matemática y Aplicaciones Avanzadas
Respuesta corta
Es aquí donde emergen los métodos probabilísticos. Lejos de ser un recurso de último orden para cuando "falta información", la probabilidad se ha consolidado como el lenguaje formal de la modelización moderna.
En pocas palabras
- Durante siglos, el pensamiento científico occidental estuvo dominado por el paradigma determinista clásico, heredado de la física newtoniana y la filosofía cartesiana.
- Para construir un edificio analítico sólido sobre la incertidumbre, el matemático ruso Andréi Kolmogorov revolucionó la disciplina en 1933 al axiomatizar la teoría de la probabilidad utilizando la teoría de la medida.
- El paraguas de los "métodos probabilísticos" es sumamente amplio y abarca disciplinas tan diversas como la estadística matemática, la investigación de operaciones, la inteligencia artificial y la física computacional.
- Dentro de los métodos de inferencia, la discusión filosófica y práctica ha estado dominada por dos corrientes metodológicas que interpretan el concepto mismo de "probabilidad" de formas radicalmente distintas.
- En esta primera sección hemos sentado las bases formales: el espacio de probabilidad kolmogoroviano, la naturaleza de las variables aleatorias y la dicotomía fundamental entre la inferencia frecuentista y la bayesiana.
En este artículo
- El triunfo de la incertidumbre en la ciencia y la tecnología moderna
- Cimientos teóricos: el espacio de probabilidad y la medida
- Taxonomía de los métodos probabilísticos
- Inferencia estadística: el debate frecuentista vs. Bayesiano
- Próximos pasos en la exploración
- Principales algoritmos y modelos probabilísticos en acción
- Aplicaciones prácticas en la ciencia de datos y la inteligencia artificial
El triunfo de la incertidumbre en la ciencia y la tecnología moderna
Sin embargo, a medida que la ciencia avanzó hacia sistemas más complejos —desde la termodinámica estadística y la física cuántica hasta la biología molecular, la economía global y los algoritmos de aprendizaje automático—, el determinismo demostró ser una herramienta insuficiente. En el mundo real, la información nunca es completa, las mediciones contienen error instrumental, los sistemas albergan millones de variables ocultas y el futuro está intrínsecamente marcado por la aleatoriedad.
Es aquí donde emergen los métodos probabilísticos. Lejos de ser un recurso de último orden para cuando "falta información", la probabilidad se ha consolidado como el lenguaje formal de la modelización moderna. Nos permite cuantificar la ignorancia, gestionar el riesgo, optimizar decisiones bajo incertidumbre y extraer patrones significativos de océanos de datos ruidosos. Esta primera entrega de nuestra serie sobre métodos probabilísticos abordará los cimientos teóricos, la taxonomía fundamental y los enfoques analíticos que estructuran este vasto campo del conocimiento científico.
Cimientos teóricos: el espacio de probabilidad y la medida
Para construir un edificio analítico sólido sobre la incertidumbre, el matemático ruso Andréi Kolmogorov revolucionó la disciplina en 1933 al axiomatizar la teoría de la probabilidad utilizando la teoría de la medida. Todo método probabilístico riguroso se sustenta sobre un Espacio de Probabilidad, denotado formalmente por la terna tripartita:
Ω,F,P\Omega, \mathcal{F}, PΩ,F,P
Desglosemos cada componente de esta estructura fundamental para comprender su impacto en la computación y el análisis moderno:
El Espacio Muestral (Ω\OmegaΩ): Representa el conjunto universal de todos los resultados posibles o elementales de un experimento aleatorio. Por ejemplo, en el análisis del tráfico de una red de telecomunicaciones, Ω\OmegaΩ podría ser el conjunto de todas las tasas de transferencia posibles en un milisegundo dado.
La Sigma-Álgebra (F\mathcal{F}F): Es una familia de subconjuntos de Ω\OmegaΩ (llamados eventos) que cumple con propiedades de cerradura bajo el complemento y la unión numerable. En términos prácticos, define qué colecciones de resultados son "medibles" y sobre las cuales podemos asignar legítimamente una probabilidad.
La Medida de Probabilidad (PPP): Es una función de valor real definida sobre F\mathcal{F}F que asigna a cada evento un número entre 0 y 1, satisfaciendo los célebres axiomas de Kolmogorov (no negatividad, unitariedad del espacio total y aditividad numerable para eventos disjuntos).
Variables aleatorias y funciones de distribución
Sobre este espacio de probabilidad se erige el concepto de variable aleatoria (XXX), una función matemática medible que mapea los resultados del espacio muestral Ω\OmegaΩ hacia el conjunto de los números reales (R\mathbb{R}R). Las variables aleatorias se dividen fundamentalmente en dos grandes vertientes que determinan las herramientas analíticas aplicables:
Discretas: Aquellas cuyo rango es un conjunto finito o infinito numerable. Se modelan mediante funciones de probabilidad de masa (P(X=x)P(X = x)P(X=x)). Ejemplos clásicos incluyen el número de paquetes perdidos en un servidor o la cantidad de clientes que llegan a una sucursal bancaria en una hora.
Continuas: Aquellas cuyo rango abarca un intervalo continuo de números reales. Se caracterizan mediante una Función de Densidad de Probabilidad (PDF) f(x)f(x)f(x) y una Función de Distribución Acumulada (CDF) F(x)F(x)F(x), donde:
F(x)=P(X≤x)=∫−∞xf(t) dtF(x) = P(X \leq x) = \int_{-\infty}^{x} f(t) \, dtF(x)=P(X≤x)=∫−∞xf(t)dt
Comprender la naturaleza de estas distribuciones, ya sea la omnipresente distribución Normal (Gaussiana) regida por el Teorema del Límite Central, o distribuciones de cola pesada como Pareto y Weibull, es el paso cero para cualquier científico de datos, ingeniero o investigador que busque implementar métodos probabilísticos efectivos.
Taxonomía de los métodos probabilísticos
El paraguas de los "métodos probabilísticos" es sumamente amplio y abarca disciplinas tan diversas como la estadística matemática, la investigación de operaciones, la inteligencia artificial y la física computacional. Para estructurar nuestro estudio, podemos clasificar estos métodos en tres grandes familias según su propósito metodológico:
| Categoría Metodológica | Propósito Principal | Ejemplos Emblemáticos |
|---|---|---|
| Inferencia y Estimación | Deducir parámetros ocultos o leyes subyacentes a partir de muestras de datos observados. | Estimación por Máxima Verosimilitud (MLE), Inferencia Bayesiana, Cadenas de Márkov. |
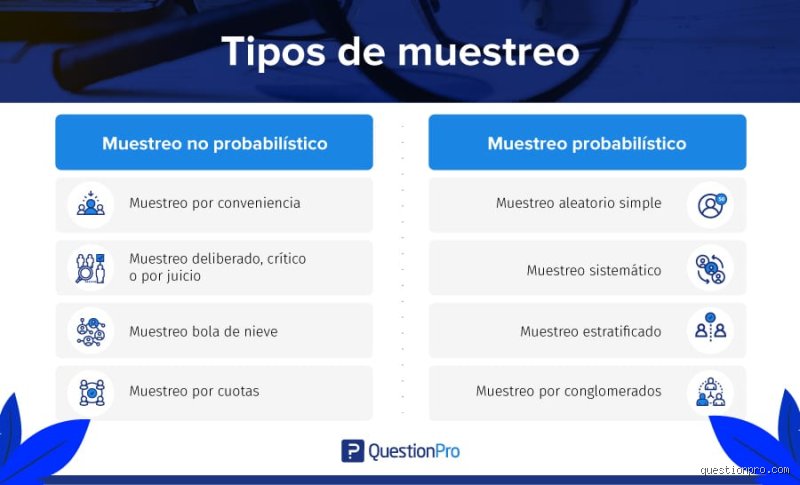
| Simulación y Muestreo | Estimar propiedades matemáticas complejas o modelar sistemas estocásticos mediante experimentación numérica. | Método de Monte Carlo, Muestreo de Gibbs, Cadenas de Márkov Monte Carlo (MCMC). |
| Optimización Estocástica | Encontrar soluciones óptimas en entornos donde la función objetivo o las restricciones contienen ruido aleatorio. | Algoritmos Genéticos, Recocido Simulado (Simulated Annealing), Optimización Bayesiana. |
Cada una de estas familias opera bajo principios matemáticos específicos y resuelve problemas donde los métodos deterministas tradicionales colapsan debido a la maldición de la dimensionalidad o a la complejidad estocástica intrínseca.
Inferencia estadística: el debate frecuentista vs. Bayesiano
Dentro de los métodos de inferencia, la discusión filosófica y práctica ha estado dominada por dos corrientes metodológicas que interpretan el concepto mismo de "probabilidad" de formas radicalmente distintas.
El Enfoque Frecuentista
Para el estadístico frecuentista, la probabilidad se define estrictamente como el límite de la frecuencia relativa de un evento tras un número infinito de repeticiones independientes bajo idénticas condiciones. Bajo este paradigma:
Los parámetros poblacionales (como la verdadera media μ\muμ o la varianza σ2\sigma^2σ2) son constantes fijas pero desconocidas.
Los datos observados son variables aleatorias generadas por un proceso de muestreo repetible.
Las herramientas centrales incluyen los intervalos de confianza y las pruebas de hipótesis (valores ppp). Un intervalo de confianza del 95% para un parámetro no significa que el parámetro tenga una probabilidad del 95% de estar en ese rango, sino que, si repitiéramos el experimento infinitas veces, el 95% de los intervalos construidos contendrían el valor verdadero.
El Enfoque Bayesiano
El enfoque bayesiano, por el contrario, interpreta la probabilidad como una medida de grado de creencia o certidumbre epistémica ante una proposición. Su motor analítico es el célebre Teorema de Bayes:
P(θ∣D)=P(D∣θ)P(θ)P(D)P( heta \mid D) = \frac{P(D \mid heta) P( heta)}{P(D)}P(θ∣D)=P(D)P(D∣θ)P(θ)
Donde:
P(θ)P( heta)P(θ) es la distribución a priori (prior), que encapsula nuestro conocimiento o creencias previas sobre el parámetro θ hetaθ antes de observar los datos.
P(D∣θ)P(D \mid heta)P(D∣θ) es la función de verosimilitud (likelihood), que mide cuán compatibles son los datos observados DDD con diferentes valores del parámetro θ hetaθ.
P(θ∣D)P( heta \mid D)P(θ∣D) es la distribución a posteriori (posterior), que representa nuestra creencia actualizada sobre el parámetro tras incorporar la evidencia empírica.
P(D)P(D)P(D) es la evidencia marginal o constante de normalización.
La gran ventaja computacional y conceptual de la inferencia bayesiana radica en su capacidad de actualizar el conocimiento de forma secuencial: el posterior de hoy se convierte en el prior de mañana a medida que ingresan nuevos flujos de datos.
Próximos pasos en la exploración
En esta primera sección hemos sentado las bases formales: el espacio de probabilidad kolmogoroviano, la naturaleza de las variables aleatorias y la dicotomía fundamental entre la inferencia frecuentista y la bayesiana.
...(Continuación del artículo experto sobre Métodos Probabilísticos)
Principales algoritmos y modelos probabilísticos en acción
Para comprender la verdadera dimensión de los métodos probabilísticos, es necesario examinar las herramientas y modelos específicos que han transformado la teoría matemática en soluciones aplicadas. A continuación, se detallan los tres pilares fundamentales que dominan el panorama actual de la analítica avanzada y la inteligencia artificial:
Cadenas de Markov y procesos estocásticos
Una Cadena de Markov es un modelo matemático que describe una secuencia de eventos posibles en los que la probabilidad de que ocurra cada evento depende únicamente del estado alcanzado en el evento anterior. Esta propiedad, conocida como memoria markoviana ("el futuro depende del presente, no del pasado"), simplifica enormemente el cálculo de sistemas complejos.
Aplicaciones: Modelado de clima, análisis financiero de volatilidad de precios, sistemas de recomendación en tiempo real y algoritmos de navegación web (como el famoso PageRank original de Google).
Métodos de Monte Carlo (MCMC)
Cuando un sistema es tan complejo que las ecuaciones analíticas son imposibles de resolver de manera exacta, los métodos de Monte Carlo acuden al rescate. Utilizan simulaciones basadas en muestreo aleatorio repetido para obtener resultados numéricos aproximados. Las variantes avanzadas, como las cadenas de Markov Monte Carlo (MCMC), permiten explorar espacios de probabilidad de alta dimensión, lo cual es vital en la inferencia bayesiana moderna.
Aplicaciones: Estimación de riesgos financieros, simulación de partículas en física cuántica, diseño de fármacos y optimización de cadenas de suministro globales.
Redes bayesianas y grafos probabilísticos
Las redes bayesianas son modelos gráficos probabilísticos que representan un conjunto de variables aleatorias y sus dependencias condicionales a través de un grafo acíclico dirigido (DAG). Permiten combinar el conocimiento experto previo con nuevos datos observados para actualizar las creencias sobre un evento incierto de manera rigurosa.
Aplicaciones: Diagnóstico médico asistido por computadora, sistemas de detección de fraudes bancarios y mantenimiento predictivo en la industria aeroespacial.
Aplicaciones prácticas en la ciencia de datos y la inteligencia artificial
En el corazón de la revolución tecnológica actual se encuentra la intersección entre la probabilidad y el aprendizaje automático (Machine Learning). A diferencia de los sistemas basados puramente en reglas deterministas, los algoritmos probabilísticos están diseñados para prosperar en entornos donde la información es incompleta, ruidosa o intrínsecamente ambigua.
Clasificación bayesiana ingenua (Naive Bayes)
Uno de los clasificadores más eficientes y utilizados en el procesamiento de lenguaje natural (PLN) es el clasificador Naive Bayes. Basado en el teorema de Bayes, asume independencia condicional entre las características dado el valor de la clase. A pesar de esta simplificación radical, ofrece un rendimiento extraordinario en tareas como:
Filtrado avanzado de correo no deseado (spam).
Análisis de sentimiento en redes sociales.
Categorización automática de documentos legales o científicos.
Modelos ocultos de Markov (HMM)
Los Modelos Ocultos de Markov extienden las cadenas de Markov estándar